
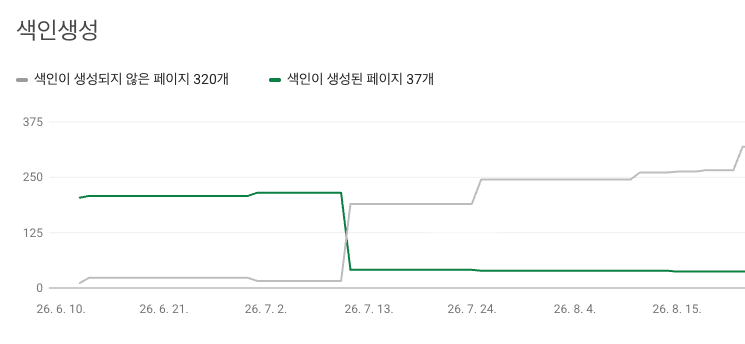
이 그래프를 나는 8월 중순에 봤다. 붕괴는 7월 11일이었다. 한 달 동안 몰랐다.
색인 나락
서치콘솔의 페이지 색인 생성 보고서는 두 개의 선으로 되어 있다. 색인된 페이지와 색인되지 않은 페이지. 7월 10일까지 이 두 선은 내가 기대한 모양이었다.
2026-07-10 색인 215 / 미색인 16
2026-07-11 색인 41 / 미색인 190
174개의 페이지가 하루 만에 "색인됨"에서 "크롤링됨 - 현재 색인이 생성되지 않음"으로 옮겨갔다.
이게 무슨 상태인지 구글 문서를 찾아봤다. 요약하면 이렇다. 페이지를 크롤링했지만 색인하지 않았다. 나중에 색인될 수도 있고 안 될 수도 있다. 다시 제출할 필요는 없다. 에러가 아니다. 차단도 아니다. 구글이 페이지를 봤고, 보고 나서 넣지 않기로 한 것이다.
의심1: 배포?
7월 초에 뭘 바꿨나. 리다이렉트를 잘못 걸었나, 템플릿을 깨뜨렸나.
$ git log --oneline --since=2026-06-22 --until=2026-07-22
(없음)
커밋이 0개였다. 6월 23일부터 7월 21일까지 29일 동안 이 저장소에는 아무 일도 없었다. 코드도, 설정도, 글도. 2편에서 말한 "너무 바빠서 한 달 발행을 안 한 기간"이었다.
의심2: 기술 이슈?
배포가 아니라면 설정이다. SEO 체크리스트를 거꾸로 돌렸다. 색인이 거부된 글 하나를 골라 하나씩 확인했다.
$ curl -sI https://<site>/posts/<slug>/ | head -1
HTTP/2 200

$ curl -s https://<site>/posts/<slug>/ | grep -o '<meta name="robots"[^>]*>'
(없음)                                  ← noindex 없음

$ curl -sI https://<site>/posts/<slug>/ | grep -i x-robots-tag
(없음)

$ curl -s https://<site>/posts/<slug>/ | grep -o '<link rel="canonical"[^>]*>'
<link rel="canonical" href="https://<site>/posts/<slug>/">   ← 자기 자신

$ curl -s https://<site>/robots.txt
User-agent: *
Allow: /
Sitemap: https://<site>/sitemap-index.xml

$ curl -s https://<site>/sitemap-0.xml | grep -c '<loc>'
(글 전부 포함)
서치콘솔의 URL 검사도 같은 말을 했다. 크롤링 허용: 예. 페이지 가져오기: 성공. 색인 생성 허용: 예. 구조화 데이터도 정상.
전부 정상이었다. 고칠 게 없었다.
의심3: 수치 오해?
이건 실제로 그랬다. 다만 좋은 쪽은 아니었다.
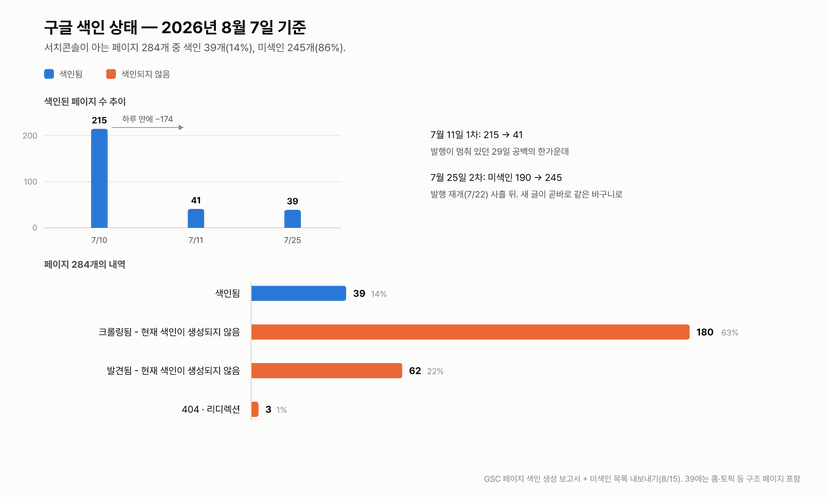
처음에 나는 "268개 중 180개가 미색인, 67%"라고 정리했다. 268에서 180을 빼서 색인이 88개는 남았다고 생각했다. 그런데 서치콘솔에서 미색인 목록을 실제로 내보내 보니 버킷이 하나가 아니었다.
색인 39, 미색인 245. 86%다. 그리고 39에는 홈과 토픽 페이지 같은 구조 페이지도 들어 있으니 글만 세면 더 적다.
"발견됨 - 현재 색인이 생성되지 않음" 62개는 더 나쁜 상태다. 크롤링됨은 그래도 구글이 페이지를 읽어보고 거절한 것이지만, 발견됨은 URL을 알면서도 읽으러 오지 않은 것이다. 읽어볼 가치도 없다고 본 셈이다.
붕괴가 한 번이 아니었다는 것도 이때 알았다. 7월 11일 1차 이후, 7월 22일에 발행을 재개했더니 사흘 뒤 7월 25일에 미색인이 190에서 245로 한 번 더 늘었다. 새로 올린 글들도 전혀 색인되지 않은 것이다.
기술 문제가 아닌 퀄리티 이슈
배포도 아니고 설정도 아니면, 남는 건 콘텐츠다. 구글이 이 사이트를 어떻게 봤을지, 구글 입장에서 사이트를 다시 훑어봤다.
글이 전부 같은 크기다. 프롬프트에 "700~1000자"라고 못 박아 뒀다. 268개 글이 전부 그 안에 있다. 사람이 쓴 사이트는 이렇게 균일하지 않다.
글이 전부 어딘가의 요약이다. 크롤러가 가져오는 건 원문이 아니라 RSS의 300자 요약이다. LLM은 그 300자를 800자로 늘린다. 인덱스에 이미 있는 원문에 더해지는 정보가 구조적으로 없다.
발행 패턴이 기계다. 하루 5~11개씩 5주. 그러다 29일 침묵. 그러다 다시 하루 여러 개. 사람이 운영하는 매체의 리듬이 아니다.
도메인이 두 달 반짜리다. 4월 27일에 연결했다. 신뢰가 쌓일 시간이 없었다.
구글 스팸 정책 문서에는 "규모화된 콘텐츠 악용"이라는 항목이 있다. 사람이 썼든 AI가 썼든, 사용자에게 더해주는 가치 없이 대량으로 만든 페이지를 겨냥한다. 나는 그 정책을 어기려던 적이 없다. 다만 위 네 가지 신호를 나란히 놓고 보면, 구글이 이 사이트를 그 프로필로 분류한 것이 이상하지 않았다.
수동 조치 통지 같은 건 없었다. 그럴 필요가 없었을 것이다. 페이지를 색인에서 빼는 데는 통지가 필요 없다. 이 상태의 정확한 의미는 차단이 아니라 유보다. 구글은 이 사이트를 막지 않았다. 그냥 넣지 않기로 했을 뿐이고, 새로 올리는 글도 같은 바구니에 넣기로 했을 뿐이다.
분석 이후..
조사를 끝내고 나서 마음에 걸린 게 두 가지 있다.
첫째, 네이버는 멀쩡했다. 같은 글 282개를 네이버 서치어드바이저는 147개 색인하고 있었다. 수집 제한 0, 색인 제외 0, SEO 이슈 0. 같은 콘텐츠를 두고 한쪽은 86%를 거부하고 한쪽은 절반 이상을 받았다. "AI가 쓴 파생 콘텐츠는 색인이 안 된다"가 보편 법칙이었다면 네이버도 거부했어야 한다. 그러니 이건 법칙이 아니라 구글의 판정이다. 판정은 바뀔 수도 있고, 안 바뀔 수도 있다.
둘째, 잃은 트래픽이 없었다. 붕괴 전후의 검색 노출을 비교해 보려고 서치콘솔 실적 보고서를 열었다. 비교할 게 없었다. 3개월 내내 노출이 하루 0~10회였다. 최고 기록이 6월 24일의 10회다. 색인 215개짜리 사이트가 하루 10번 노출됐다. 붕괴는 트래픽을 빼앗아 간 게 아니었다. 애초에 없었다.
나는 며칠 동안 "색인을 어떻게 회복하느냐"를 붙들고 있었다. 그런데 색인이 있던 때에도 아무도 오지 않았다면, 회복해서 뭘 하려는 것이었을까.