
지난 4월, 나는 AI가 매일 글을 써주는 사이트를 만들었다. 그동안 글 283개가 쌓였다. 그리고 그 중 대다수가 갑자기 색인이 잡히지 않았다.
이 시리즈는 그 시행착오의 기록이다. 다만 무너진 이야기를 하려면, 먼저 쌓아 올린 이야기부터 해야 한다. 1편은 내가 무엇을 계획했고 어떻게 만들었는지에 대한 글이다.
시작은 나를 위한 도구였다
발단은 단순했다. IT/AI 업계는 하루만 한눈팔아도 새 모델, 새 논쟁, 새 서비스가 쏟아진다. 이걸 매일 따라잡는 것도 일이라, 동향을 알아서 모아서 정리해주는 도구를 하나 만들까 고민하던 참이었다.
그러다 문득, 어차피 매일 모아서 정리할 거라면, 나 혼자 보는 도구로 끝내지 말고 남들도 볼 수 있게 사이트로 배포하면 어떨까라는 생각이 들었다.
그 순간 프로젝트의 성격이 바뀌었다. 개인용 스크립트가 아니라, 매일 아침 발행할 만한 초안이 알아서 쌓여 있는 시스템을 처음부터 끝까지 직접 만들어보는 것. 크롤링과 LLM 가공, 초안 축적까지는 기계가 하고, 나는 읽고 다듬어서 발행 버튼을 누르는 구조다. 아무 글이나 사이트에 나가면 안 되니까 발행이라는 마지막 결정은 내가 처리해야 할 몫으로 남겨뒀다. 이렇게 사람의 개입을 최소화한 파이프라인 설계 경험을 해보는 것이 프로젝트의 1순위 목표가 됐다.
물론 2순위 목표도 있었다. 유입이 쌓이면 애드센스를 붙여서 커피값이라도 나오지 않을까 하는 욕심.
설계 원칙: 돈을 쓰지 않는다
기본 원칙은 두 개. 돈을 쓰지 않는다, 운영에 최대한 손이 가지 않게 한다.
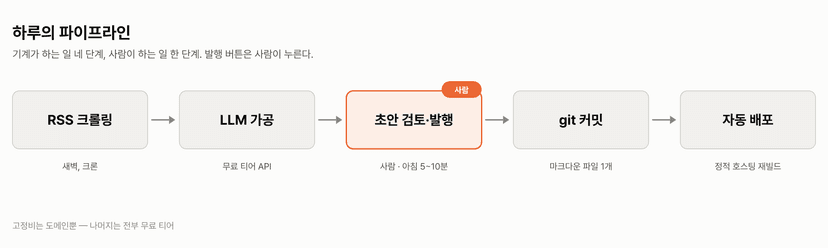
공개 사이트는 서버 없이 순수 정적 HTML만 뽑는 프레임워크로. 백엔드는 서버리스 무료 티어로. 그리고 발행된 글은 DB에 넣는 대신 git 저장소에 마크다운 파일로 커밋하기로 했다. 글이 발행될 때마다 저장소에 커밋이 하나 쌓이고, 그걸 감지한 호스팅이 사이트를 자동으로 다시 빌드하는 방식이다. DB 비용은 0원이 되고, 백업과 버전 관리도 git으로 하니 0원.
이 조합의 고정비는 사실상 도메인 값뿐이다. 1년에 10달러 미만. 트래픽이 아무리 늘어도 비용이 두려울 일이 없는 구조를 만들어 놓고 시작했다.
싸게 만들되, 싸구려는 안 되게
하지만 돈을 안 쓴 서비스는 결과물에서도 돈을 안 쓴 티가 난다. 그래서 운영하며 시행착오를 겪을 때마다 품질 기준을 하나씩 세웠고, 그때마다 시스템을 고쳤다.
읽을 만한 글: 무료 LLM을 쓰지만 결과물까지 무료 티가 나면 안 된다. 번역투와 AI 특유의 말버릇을 걷어내는 규칙을 프롬프트에 계속 쌓았다.
억지 인사이트 금지: LLM은 글마다 하나 마나 한 교훈을 붙이려 든다. 시사점이 없으면 없는 대로 끝낸다.
중복 금지: 같은 사건이 출처만 다르게 여러 글로 나오지 않게, 비슷한 주제는 한 편으로 합친다. 한 번 발행한 주제는 다시 쓰지 않는다.
살아있는 소스: 언론 보도만 모으지 않고, 해커뉴스·레딧 같은 커뮤니티에서 실제 개발자들이 논의하는 주제를 최대한 수집했다.
저작권 안전: 원문 문장을 옮겨 쓰지 않도록 프롬프트에 가드를 넣고, 모든 글에 출처 링크를 명시했다.
자동 태깅: 글마다 태그를 자동으로 붙여 주제별로 모아볼 수 있게 했다. (열심히 구현했지만 큰 쓸모는 없었음)
OG 이미지 자동 생성. 링크를 공유하면 글마다 고유 썸네일이 뜨도록 했다.
이 밖에도 잔손질이 많았다. LLM 토큰 소진율은 매일 자동 리포트로 받았다. 본문 폰트를 예쁜 걸로 바꿨다가 성능 점수가 떨어져서 롤백한 적도 있다.
이 기준들은 전부 한 번씩 데인 뒤에 생겨서 쌓아올린 것들이다.
발행 사이클
시스템이 굴러가는 사이클은 이렇다.
오전 8시에 크론이 돈다. 해커뉴스, 레딧, 국내외 테크 미디어의 RSS를 긁어서 지난 하루 동안 화제가 된 글감을 모은다. LLM이 그중 쓸 만한 주제를 골라 한국어 글로 가공한다. 단순 번역이 아니라 "무슨 일이 있었고, 왜 화제인지"를 요약하는 짧은 글이다. 결과물은 발행 대기 초안으로 쌓인다. 하루 최대 6건.
나는 데일리로 관리자 페이지를 열고 밤새 생성된 초안들을 훑는다. 이상한 글은 버리고, 어색한 문장은 고치고, 괜찮은 글은 발행 버튼을 누른다. 버튼을 누르면 마크다운 파일이 저장소에 커밋되고, 몇 분 뒤 사이트에 글이 올라온다.
글은 기계가 쓰되, 발행 버튼은 사람이 누른다. 검토에 드는 시간은 하루 5~10분. 그 정도면 운영 부담이 없는 범위라고 생각했다. 또, 발행을 결정하기 위해 억지로라도 글을 읽으면서 동향을 저절로 파악하게 된다. 매일 발행이 나름의 원칙이지만 발행 없이 넘어가는 날들도 많았고, 중간에 1달 정도는 너무 바빠서 아예 발행을 안한 기간도 있었다.
[이미지 추가: 관리자 페이지에서 초안 목록을 검토하는 화면 스크린샷 — 글 제목·도메인 등 식별 요소는 블러 처리]
SEO: "구글이 좋아한다는 건 다 했다"
트래픽의 대부분은 검색에서 올 것이라고 생각했다.
순수 정적 HTML: 자바스크립트를 꺼도 본문이 통째로 읽힌다. 크롤러가 못 읽는 콘텐츠는 없는 콘텐츠나 마찬가지라고 봤다.
페이지마다 canonical URL과 메타 태그: 제목, 설명, OG, 트위터 카드까지 전부.
구조화 데이터(JSON-LD): 사이트는 WebSite/Organization으로, 글 하나하나는 NewsArticle 스키마로 선언했다. 글이 인용한 출처 목록까지 citation 속성으로 박아 넣었다.
시맨틱 마크업: article, time 같은 태그를 지키고, 발행일·수정일을 기계가 읽는 datetime 형식으로 명시했다.
자동 생성 sitemap과 RSS 피드: 새 글이 나가면 즉시 반영된다.
AI 검색 대비까지: 구글만 본 게 아니다. LLM 크롤러가 사이트의 전체 글 목록을 한 번에 파악하도록 llms.txt를 동적 생성하고, 글마다 LLM 친화 요약과 핵심 포인트 필드를 따로 뒀다. 네이버 서치어드바이저 등록도 마쳤다.
기술 블로그들이 "구글이 좋아한다"고 말하는 항목은 거의 다 채웠다고 자신할 수 있었다. 기술적으로 완벽한 사이트에 글을 꾸준히 쌓으면, 색인과 유입은 따라온다고 생각했지만..!
순항: 5주 만에 글 193개
4월 26일에 첫 글이 나갔다. 시스템은 기대보다 잘 돌았다. 하루에 5~11개씩, 5월 한 달에만 174개. 첫 5주 동안 193개의 글이 쌓였다.
구글 서치콘솔에는 색인된 페이지가 하나둘 잡히기 시작했고, 검색 유입도 아주 조금씩 들어왔다. 발행량 그래프는 우상향, 색인 그래프도 우상향. 매일 아침 새 글이 올라와 있는 사이트를 보는 기분은 예상대로 꽤 좋았다.
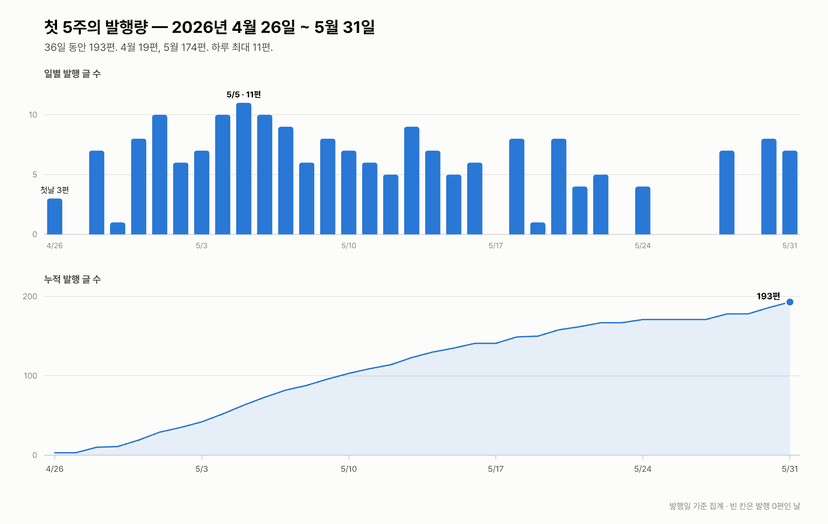
시스템을 만든다는 목표는 이룬 셈이었다. 남은 건 유입이 쌓이기를 기다리는 것뿐이라고 생각했다.